AI-teknik för SOC-automation
I början av 2000-talet började vi använda algoritmer för maskininlärning för att identifiera skadliga program. Sedan dess har angripare förbättrat sina metoder. Dagens riktade attacker kännetecknas av att de är mycket svårupptäckta – i synnerhet genom minimal användning av skadliga program som kan detekteras av antivirusprogramvar. Istället använder många angripare social ingenjörskonst för att få första åtkomst, och utnyttjar sedan felkonfigurationer i systemen samt legitim programvara för att röra sig i nätverket och etablera ett varaktigt fotfäste i den komprometterade infrastrukturen.
För att detektera sådana attacker krävs insamling och analys av en stor mängd data om beteendet hos enheter, applikationer och användare i företagets nätverk. Och varje gång en misstänkt aktivitet detekteras måste händelsen verifieras som en attack eller som legitim aktivitet. I takt med att antalet tillgångar i en organisation växer, ökar även mängden insamlad telemetri, vilket innebär en ökad belastning på analytiker som arbetar inom Security Operation Centers och MDR-tjänster.
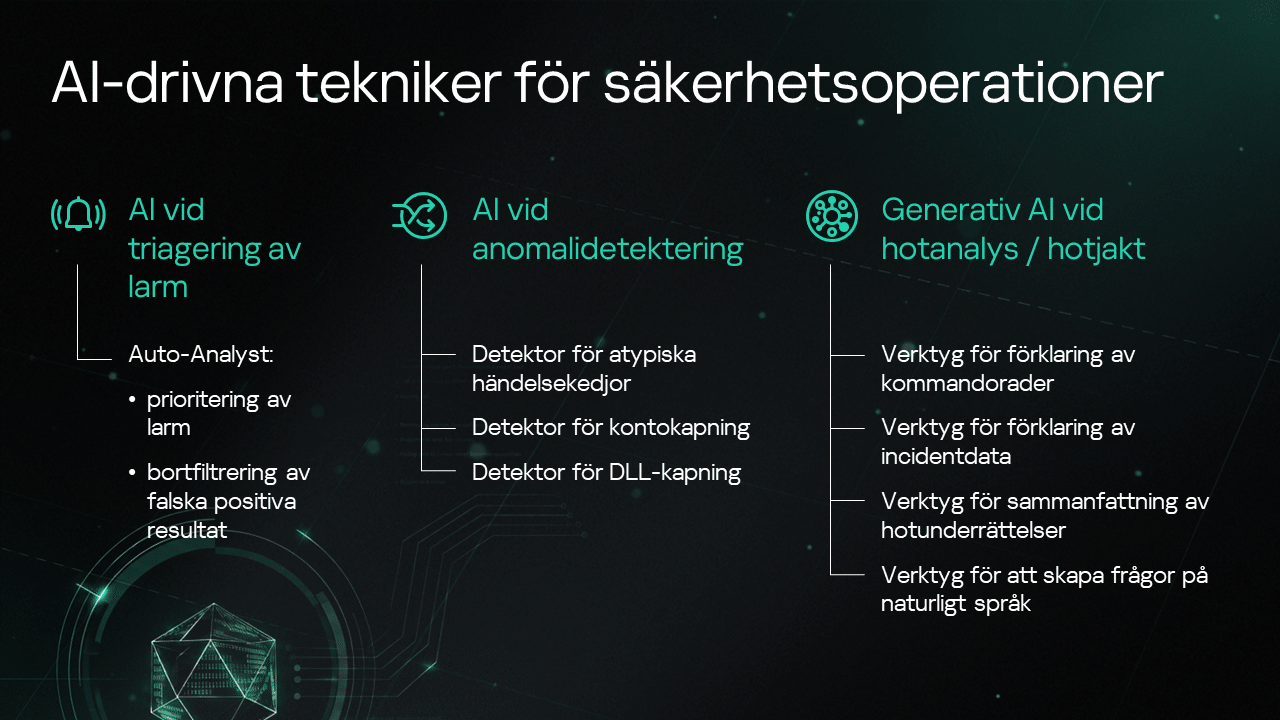
Automatisering baserad på AI-teknik gör det möjligt att avsevärt förenkla detta arbete inom flera områden:
- Triage: prioritera varningar om misstänkta händelser inom MDR/XDR/SIEM-telemetri, filtrera bort falsklarm.
- Identifiera beteendeavvikelser: identifiera tecken på kontostöld, kompromettering av värddator, DLL-kapningsattacker och andra skadliga aktiviteter.
- Datapresentation: sammanfatta och tolka kommandorader, incidenter och TI-rapporter.
- Hotjakt på ett naturligt språk: översätta analytikers hypoteser till SQL-frågor.
Nedan beskriver vi hur dessa AI-tekniker implementeras i praktiken i våra produkter och tjänster.
Automatisk analys och prioritering av varningar
Infrastrukturerna hos våra MDR-tjänsteklienter genererar miljarder säkerhetshändelser varje dag. Datainsamlingssystemet identifierar misstänkta händelser baserat på särskilda detekteringsregler och rapporterar denna potentiellt skadliga aktivitet till analytiker i form av varningar; flera hundra tusen meddelanden årligen. Endast omkring en tiondel av dessa varningar kommer dock att gälla faktiska säkerhetsincidenter.
Analytiker har alltså i uppgift att filtrera bort de "falsklarm" som utgör merparten av alla varningar. För att hantera detta utvecklade vi ett AI-system som heter Auto-Analyst. Detta system för övervakad maskininlärning tränas på varningar märkta med bedömningar från SOC-analytiker. Målet är att på ett säkert sätt identifiera falska positiva resultat som orsakats av legitim nätverksaktivitet.
Maskininlärningen bygger här på CatBoost – ett populärt bibliotek för gradientförstärkning. Den tränade Auto-Analyst-modellen filtrerar varningar och skickar endast vidare för mänsklig granskning de som bedöms ha en sannolikhet över ett visst tröskelvärde för att vara en verklig incident – en sannolikhet som fastställs utifrån den acceptabla felfrekvensen. Detta resulterar i att cirka 30 % av varningarna enbart hanteras av AI, vilket frigör SOC-teamets tid för mer komplexa åtgärder. De varningar som når mänsklig analys har dessutom prioriterats, så att analytikerna kan fokusera på de mest kritiska fallen först.
Mer information om de praktiska nyanserna i Auto-Analysts arbete (kontrollera träningsdata, selektiv granskning av resultat osv.) finns i en separat artikel av våra experter.
Avvikelseupptäckt i SIEM
Kärnan i detta tillvägagångssätt är att använda telemetri som erhållits under systemets "friska" funktion för att träna en AI-modell som sedan kommer att signalera avvikelser från normalt beteende.
Att använda sådana algoritmer i stora distribuerade system kompliceras av det enorma antalet parametrar som måste beaktas vid uppbyggnad av modellen. Sådana modeller kan ge ett stort antal falsklarm: i en organisation med tusentals användare kan många fall av avvikande beteende vara legitima.
Detta tillvägagångssätt kan dock användas mycket framgångsrikt för separata tillgångar och processer där det är möjligt att bygga en tillräckligt noggrann modell för normal funktion.
Onormala händelsekedjor
I det här fallet används data om typiska sekvenser av utlösta korrelationsregler i ett SIEM-system för att skapa en modell av normalt beteende. Frekventa utlösare i samma sekvens är vanligtvis falsklarm (t.ex. automatisk körning av administrativa skript), och dessa kan användas som en indikator på typisk aktivitet inom infrastrukturen.
Genom att bygga en profil över typiskt värdbeteende – uttryckt som sannolikheter för att vissa regler utlöses – kan vårt AI-system utvärdera hur typisk eller atypisk varje ny händelsekedja är för den givna infrastrukturen. Upptäckt av en atypisk kedja leder till att systemet höjer varningens prioritet, vilket riktar säkerhetsspecialisters uppmärksamhet mot händelsen för en mer ingående analys.
Kontostöld
En annan teknik för avvikelsedetektering möjliggör upptäckt av potentiellt obehörig aktivitet på användarkonton. Här använder maskininlärningssystemet par av entiteter som 'konto-IP', 'konto-värd', 'konto-land' osv. för att skapa profiler över typiskt kontobeteende.
En angripare som använder ett stulet konto avviker vanligtvis från det normala aktivitetsmönstret. Angripare loggar in på systemet från ovanliga adresser och letar sedan efter sätt att röra sig i systemet eller eskalera behörigheter i systemet, genom att besöka noder i infrastrukturen som den legitima kontoanvändaren inte kommer att ha besökt. AI-systemet upptäcker sådana avvikelser och samlar in det nödvändiga sammanhanget i en varning, vilket gör det möjligt för analytiker att snabbt agera vid sådana incidenter.
DLL-kapning
DLL-kapning är en attackteknik i Windows OS där angripare ersätter ett bibliotek som anropas av en legitim process med ett skadligt bibliotek. Upptäckt av sådana attacker med klassiska säkerhetslösningar är inte lätt eftersom det skadliga biblioteket körs inom det tillförlitliga adressutrymmet för en legitim process, så den här aktiviteten kan se ut som en pålitlig process för en säkerhetslösning. Det är inte förvånande att antalet attacker som utnyttjar DLL-kapning har ökat avsevärt under de senaste åren.
För att bygga en AI-modell som skiljer mellan skadliga och legitima biblioteksinläsningar har våra experter identifierat ett antal funktioner som uppstår i misstänkta fall: fel biblioteksplats, fel körbar plats, körbar fil som döpts om, ändringar i bibliotekets storlek och struktur, avsaknad av signatur osv. Som träningsunderlag använde vi data om DLL-inläsningar från våra interna automatiska bearbetningssystem samt anonymiserad användartelemetri från KSN.
Mer information om träningsprocessen för denna modell finns i en separat rapport. Redan i pilotstadiet har tekniken bidragit till att förhindra flera attacker i våra kunders system.
AI-assistenter baserade på generativa modeller
Alla tidigare exempel rör användningen av AI som klassificerare: givet ett nytt informationsobjekt anger modellen att det tillhör en viss klass ('det är en hund'). Sådana maskininlärningssystem tränas vanligtvis på ett begränsat urval av data som är direkt tillämpbart på uppgiften.
Generativ AI fungerar "omvänt". Systemet tar emot en beskrivning av ett önskat resultat som en förfrågan (”rita en hund åt mig”) och genererar nya informationsobjekt av den önskade typen. För att göra detta använder systemet omfattande ”kunskap” inom ämnesområdet som har erhållits genom förträning av en stor språkmodell (LLM) på enorma mängder offentlig data.
Detta gör det möjligt att använda LLM-baserade system för en mängd olika åtgärder, bland annat arbete med ostrukturerad data. Dagens LLM:er är särskilt bra på att hantera textbearbetningsåtgärder – såsom översättning, tolkning och sammanfattning (dvs. att skapa en kort version av originaltexten med bibehållna idéer).
För att lösa liknande uppgifter inom textbearbetning i säkerhetsprodukter och tjänster har vi utvecklat en egen teknik för AI-assistenter. Tekniken förbereder data för frågor till stora språkmodeller (LLM), utformar och skickar frågor, behandlar resultat och vidarebefordrar dem till analytiker samtidigt som hela kommunikationsprocessen är säker.
AI-assistenten kan arbeta med vilken LLM som helst som kunden väljer, beroende på deras uppgifter och krav. Till exempel är molnmodeller vanligtvis kraftfullare än de som används lokalt, men när du använder lokalt installerade modeller undviker du överföring av konfidentiell data till tjänster från tredje part.
Tolkning av kommandorader
En obfuskerad kommandorad är en vanlig typ av misstänkt händelse som kräver noggrann granskning av en analytiker. Angripare använder sådana kommandorader för att ge instruktioner direkt till operativsystemet på den angripna värden, samtidigt som de undviker upptäckt. För att dölja skadliga kommandon använder de kodning, syntaxmanipulering och en rad andra metoder för att dölja innebörden, vilket gör det svårt att identifiera de verkliga avsikterna hos den som skapat kommandot.
Vår AI-assistent utför först en statisk avobfuskering den misstänkta raden. Sedan skickar den en rad frågor till en stor språkmodell (LLM) för att få en förklaring av alla kommandoradsparametrar. Avslutningsvis presenterar assistenten en sammanfattning för analytikern: vad raden gör och hur farlig den är.
Sammanfattning av incidentdata
För att automatisera incidenthanteringen använder dagens SOC funktionalitet från en plattform för incidenthantering (Incident Response Platform, IRP). Detta program samlar all data som rör en incident i ett enda objekt, inklusive relaterade säkerhetshändelser och artefakter.
En sådan datainsamling kan dock vara mycket stor, och manuell analys av alla händelsedetaljer tar tid. Dessutom finns det situationer där analytiker behöver komma ihåg gamla incidenter – vilket kräver att gamla pusselbitar sätts ihop igen.
GenAI-assistenten förenklar detta arbete avsevärt. Den samlar in all telemetri som är relaterad till händelsen och skapar, med hjälp av en språkmodell (LLM), en kortfattad förklaring av händelseförloppet, inklusive den initiala attackvektorn och angriparens agerande under händelsen, tillsammans med rekommendationer om hur man bör reagera.
Sammanfattning av Threat Intelligence (TI)
Vid utredning av en incident vänder sig analytiker ofta till ytterligare informationskällor gällande det aktuella hotet. En sådan källa är vår Threat Intelligence Portal (TIP) som innehåller över fem petabyte TI som samlats in av Kaspersky under mer än ett kvarts sekel av arbete med hotdetektering: hashvärden för skadliga filer, statistiska och beteendemässiga egenskaper, IP-adresser och webbadresser till lednings- och kontrollcentraler, TTP:er för hackergrupper osv.
Ett typiskt scenario för att arbeta med portalen ser ut så här. En analytiker laddar upp ett misstänkt exempel som påträffats under en incidentutredning och kör det i portalens sandbox. Som ett resultat får de en detaljerad analys: bedömningar och hashvärden av upptäckta skadliga program, domänadresser de kontaktade, nedladdade filer från internet osv.
All denna data kan användas som parametrar för att söka efter ytterligare TI från öppna källor. Till exempel kan portalen visa rapporter om en APT-grupp som använder samma C2-adresser som de som upptäcktes när exemplet kördes i sandboxen. Detta ger analytikern ytterligare indikatorer på intrång (IoC) att kontrollera i infrastrukturen.
Det kan dock ta lång tid att studera olika TI-rapporter, särskilt om de är skrivna på olika språk och i olika format. Vår AI-assistent skapar en strukturerad sammanfattning av TI-rapporter som visar hur en viss indikator kopplas till en specifik grupp, var och när den var aktiv, vilka tekniker den använder osv. På samma sätt kan AI-assistenten skapa en strukturerad beskrivning av en viss APT-grupp baserad på OSINT-data.
Hotjakt på ett naturligt språk
När en analytiker vill hämta ytterligare data om den pågående incidenten eller proaktivt identifiera ett hot baserat på nyligen mottagna indikatorer måste denne formulera en fråga mot en logglagring eller SIEM/EDR/XDR-databas, där säkerhetshändelser samlas in . Att översätta analytikerns hypotes till SQL-frågor med exakt syntax och korrekta parametrar kan dock ta avsevärd tid, vilket kan fördröja utrednings- och hanteringsprocesser.
Vår AI-assistent gör det möjligt för analytiker att formulera frågor till databasen på naturligt språk – alltså direkt på hypotesnivå. En analytiker kan till exempel säga: ”visa alla händelser som inträffade igår på vissa specifika värddatorer, där en körbar fil med ett sådant namn var inblandad." Vid mottagandet av denna begäran använder AI-assistenten en språkmodell (LLM) för att välja relevanta fält från datamodellen och skickar därefter en SQL-fråga till databasen. Innan den faktiskt körs kan analytikerna granska den AI-genererade frågan, kontrollera dess logik samt justera parametrar eller syntax vid behov.


